Cómo elegimos el modelo de aprendizaje automático que hay detrás de tu previsión. Un vistazo entre bastidores a más de 15 modelos, 4.000 observaciones de rebozuelos del condado de Mayo y el examen justo de 2025.
En 2021, el máximo de los rebozuelos en Irlanda llegó en septiembre. En 2025 llegó en julio. Dos meses de diferencia, la misma especie, el mismo país. Los calendarios no siempre cuadran, el tiempo cambia de un año a otro y lo que apuntaste el año pasado no siempre se repite. En el condado de Mayo, nuestro equipo ha reunido más de 4.000 observaciones verificadas de rebozuelos en seis años, y en 2025 cogimos esos datos y sometimos a 15 modelos de aprendizaje automático distintos a un examen justo. Este artículo cuenta cómo los comparamos, cuál ganó y por qué ahora usas justo ese modelo en ShroomCast.
Por qué prever setas
El bosque no es un calendario. Mira en un solo gráfico las observaciones de rebozuelos en toda Irlanda de las últimas 7 temporadas.
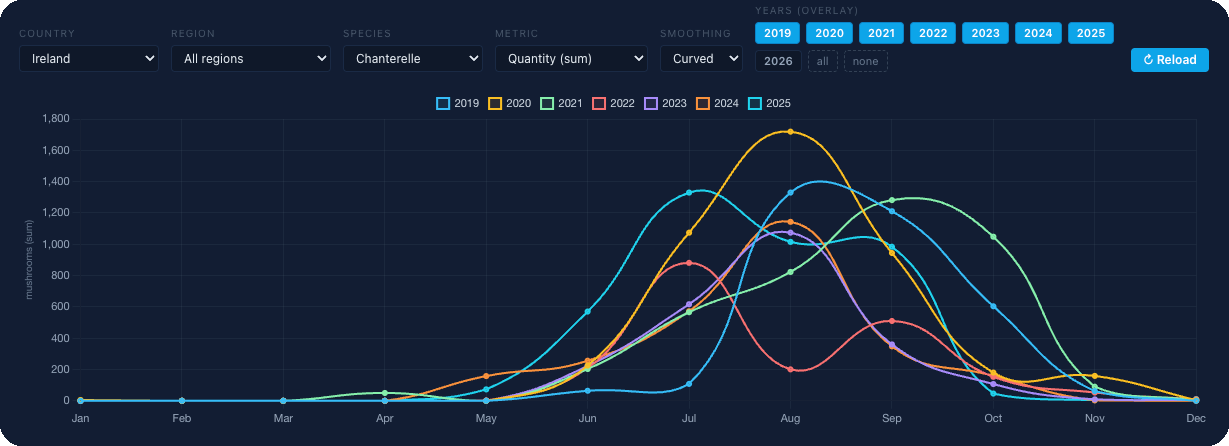
En 2021 habrías ido al bosque en julio y solo habrías encontrado musgo. En 2025 habrías esperado a septiembre y te habrías perdido el máximo por seis semanas. No es una rareza puntual, es lo normal. La temperatura, la lluvia, la humedad del suelo, el tipo de bosque y los ciclos lunares mueven la salida días y semanas, y todo junto puede llevar el máximo de la temporada de julio a septiembre y vuelta.
Por eso durante siglos se ha salido al monte «a ojo», con señales poco precisas como «después de la tormenta, dentro de cuatro días, ve al robledal». En algunos bosques y algunas temporadas funciona. A escala de un país y de un año entero, es una lotería.
Con datos, el problema tiene solución. Si tienes miles de salidas de setas registradas de verdad en una región y ligadas al tiempo de esos días, puedes encontrar patrones en esos datos y prever la siguiente tanda. Ese es el problema que ShroomCast existe para resolver.
Los datos, la base de todo
Con la versión actual, estas son las cifras.
- Más de 1 millón de observaciones de setas verificadas desde 2019.
- Más de 360 regiones de Europa cubiertas por el modelo.
- Más de 7 años de datos meteorológicos para cada una de esas regiones.
- 14 especies modeladas una a una (rebozuelo, boletus, colmenilla, níscalo, boleto bayo, armilaria y otras).
Reunimos las fuentes siempre de la misma manera, con bases de datos públicas de observaciones, los registros de campo de nuestro propio equipo y fuentes de confianza con las que trabajamos directamente. Cada registro no es solo «lo encontré este día», sino un trío (región, especie, fecha) con todo el contexto del tiempo y del suelo alrededor de ese día.
Qué analizamos
Cada especie en cada región se modela por separado. El rebozuelo tiene sus desencadenantes, la colmenilla los suyos y el boletus los suyos. Dentro de un modelo miramos cinco grupos de variables.
- Tiempo: temperatura del aire, lluvia, humedad, presión atmosférica y nubosidad.
- Suelo: temperatura del suelo, humedad del suelo y composición.
- Bosque: tipo (coníferas, frondosas, mixto), altitud y microclima local.
- Ciclos naturales: fases lunares, patrones de temporada y ventanas de salida propias de cada especie.
- Dinámica histórica: qué pasó en esta región con esta especie en años anteriores con condiciones parecidas.
Caso práctico: rebozuelos en el condado de Mayo, Irlanda
Para enseñar cómo elegimos un modelo, tomaremos una región y una especie. Mayo es el banco de pruebas ideal por varias razones, como un gran volumen de observaciones durante muchos años (más de 4.000 solo de rebozuelo), y además completamos los datos con los de rebozuelos de toda Irlanda para tener contexto.
De 2019 a 2024 fue nuestro periodo de entrenamiento. Los modelos «aprendieron» con esas seis temporadas qué combinaciones de tiempo y suelo precedieron a salidas reales de setas y cuáles no. Dejamos 2025 sin tocar. Ese era el futuro que ningún modelo había visto durante el entrenamiento.
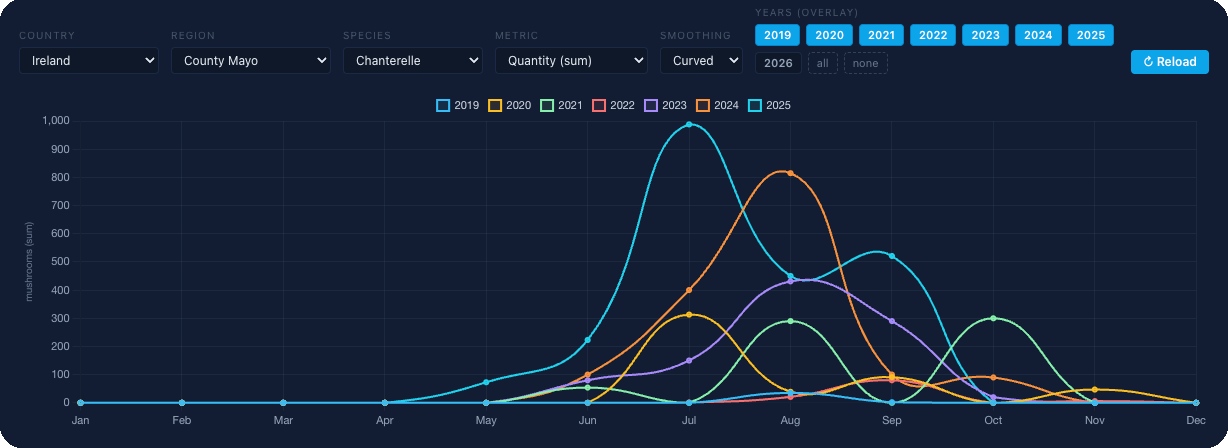
Cada punto del gráfico de arriba es un hallazgo de nuestro equipo o una observación verificada de fuentes de confianza con las que trabajamos. Nada de datos inferidos. Solo lo que una persona vio y registró de verdad.
Cómo elegimos el modelo
Esta es la parte que casi nadie ve, el concurso entre modelos.
Probamos más de 15 arquitecturas de aprendizaje automático distintas. Sus nombres concretos importan menos que el planteamiento. Cada modelo miraba los mismos datos y tenía que aprender a prever la probabilidad de que salieran rebozuelos en Mayo cada semana de 2025. Dentro de cada arquitectura probamos decenas de variantes, con distintos horizontes de variables, distintas estrategias de regularización y distintas formas de codificar la estacionalidad.
La regla principal de selección era esta. Un modelo no se juzgaba por lo bien que recordaba los datos antiguos (cualquier artilugio sobreajustado lo consigue), sino por lo bien que previó 2025, el año que no había visto durante el entrenamiento. Ese es el examen justo.
Modelo 1 frente a modelo 2
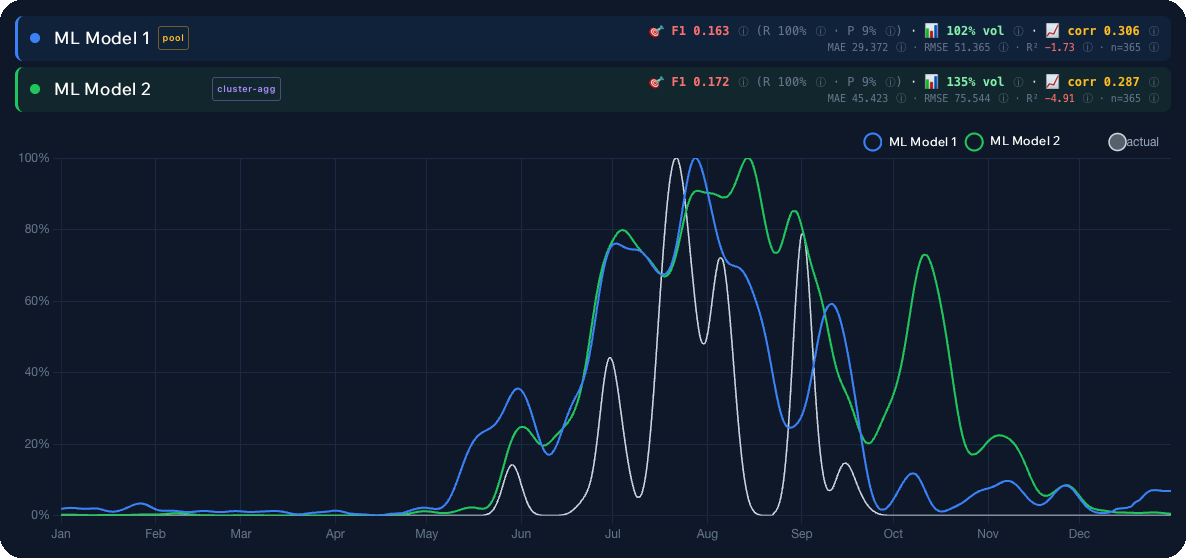
El gráfico de arriba muestra el mismo conjunto de observaciones reales de 2025 con las previsiones de dos modelos finalistas encima. La línea azul (ML Model 1) sigue con limpieza las salidas reales. Detecta el inicio de la temporada, no se pierde el máximo de agosto y baja como debe a lo largo de octubre. La otra variante se queda atrás o exagera la intensidad en las semanas «tranquilas».
A simple vista la diferencia parece pequeña, pero en la práctica es enorme. Una previsión «Excelente» de más en una semana sin setas te cuesta un día perdido y un depósito de gasolina. Un máximo que se escapa te cuesta la temporada. Por eso ganó el modelo que, de media, menos engañó a quien lo usaba en 2025.
Repetimos el mismo proceso para cada especie y para cada una de las más de 360 regiones. La misma arquitectura no ganó en todas partes. En las regiones con menos observaciones ganaron modelos más prudentes, y en las regiones con muchos datos tomaron la delantera las variantes más sensibles. El sistema final de producción se monta con estas elecciones, las mejores en cada sitio.
Lo que de verdad llega a la app
Los modelos ganadores funcionan en producción y ahora calculan una previsión a 14 días para cada especie de tu región. Cuatro veces al día el sistema recoge el tiempo actualizado, actualiza las variables, ejecuta el modelo y publica el resultado. Tú lo ves como una escala de colores.
- 0-20 % Muy baja (morado, hoy no)
- 20-40 % Baja (azul, casi ninguna posibilidad)
- 40-60 % Media (verde, merece la pena mirar tus sitios de siempre)
- 60-80 % Alta (amarillo, las condiciones son buenas)
- 80-100 % Excelente (naranja, coge la cesta)
Así que todo lo que salió de miles de horas de entrenamiento de modelos se queda en cinco colores y una cifra al día. Así debe ser. Un modelo complejo, una respuesta sencilla.
Dónde funciona mejor y dónde no
La transparencia forma parte del producto. No todas las regiones tienen datos igual de densos, y no lo escondemos.
Lo más sólido: Reino Unido e Irlanda. Aquí tenemos la mayor densidad de observaciones y las series más largas por especie. Mayo, el caso de arriba, es el retrato de una región bien cubierta.
Bastante sólido: la mitad sur de Suecia (Götaland y la mayor parte de Svealand). Ampliamos la cobertura aquí hace poco y ya recibimos una señal estable.
Más débil: el norte de Suecia (Norrland), sobre todo el subártico Norrbotten. Las ventanas de salida son más cortas y hay menos observaciones. El modelo sigue funcionando, pero la franja de incertidumbre es más ancha. Lo mostramos con honestidad en la app. Donde hay pocos datos, la previsión es más prudente.
No es un fallo, es la forma que tiene el problema. Más datos, respuestas más precisas. Cada temporada añadimos observaciones nuevas y recalibramos los modelos.
Por qué una región y no un punto
Hay un detalle técnico que sale a menudo. ShroomCast no muestra a propósito previsiones en puntos concretos del mapa. Solo por regiones (decenas de kilómetros cuadrados).
El motivo no es técnico. Si la app dijera «en ese claro, 50 metros al norte de esta curva, hay hoy un 92 % de probabilidad de rebozuelos», una semana después ese claro ya no existiría. Los bosques no sobreviven a las incursiones guiadas por coordenadas. Por eso trabajamos a escala regional y dejamos los sitios personales a cada cual.
ShroomCast no guarda tus ubicaciones. No recuerda por dónde has caminado. No construye tu mapa personal. Es así por diseño, no por descuido.
Lo que viene
Ahora mismo la cobertura incluye Irlanda, Reino Unido, Suecia, Francia y Alemania. La próxima versión trae Países Bajos, Bélgica y Suiza. Añadimos especies nuevas cuando la base de observaciones crece lo suficiente para sostenerlas (al menos un par de miles de observaciones validadas por región, si no el modelo no tiene sentido).
Cada temporada nueva repetimos el mismo examen que hicimos con Mayo. Entrenamos con los años pasados, probamos con el actual y elegimos a los ganadores. No es el lanzamiento de un modelo y ya está, es una recalibración continua.
Para terminar
Prever setas no es magia ni adivinanza. Es un intento de ver el bosque mejor que el calendario y la intuición juntos, diciendo con honestidad dónde el modelo está seguro y dónde no.
Lo hacemos porque nosotros también salimos al monte. Todo el equipo ha perdido al menos un día por temporada en un bosque vacío, y este producto nació para dejar de perder esos días. Si te suena ese disgusto, prueba la previsión de tu región.

Gratis para empezar, con 4 especies.